技術デモ・ダウンロード不要
日本語OCRの比較
無料で
- NDLOCR-Lite国立国会図書館
- PaddleOCRBaidu
- TesseractGoogle 発
選んだ
比較
| エンジン | 文字誤り | 文字の | 行 | 処理時間 |
|---|
01結果の
数字で、比べる 。
見本は
誤り 1字正解 6字16.7%
- 置き換え 請求暑 1字の
誤り - 追加 請求書類 1字の
誤り - 削除 請求 1字の
誤り
正解は
- 文字誤り
率 - 66.7%順番の
違いも 誤りに 数える - 文字の
一致率 - 100.0%順番を
問わず、 拾えた 文字を 数える
実測でも
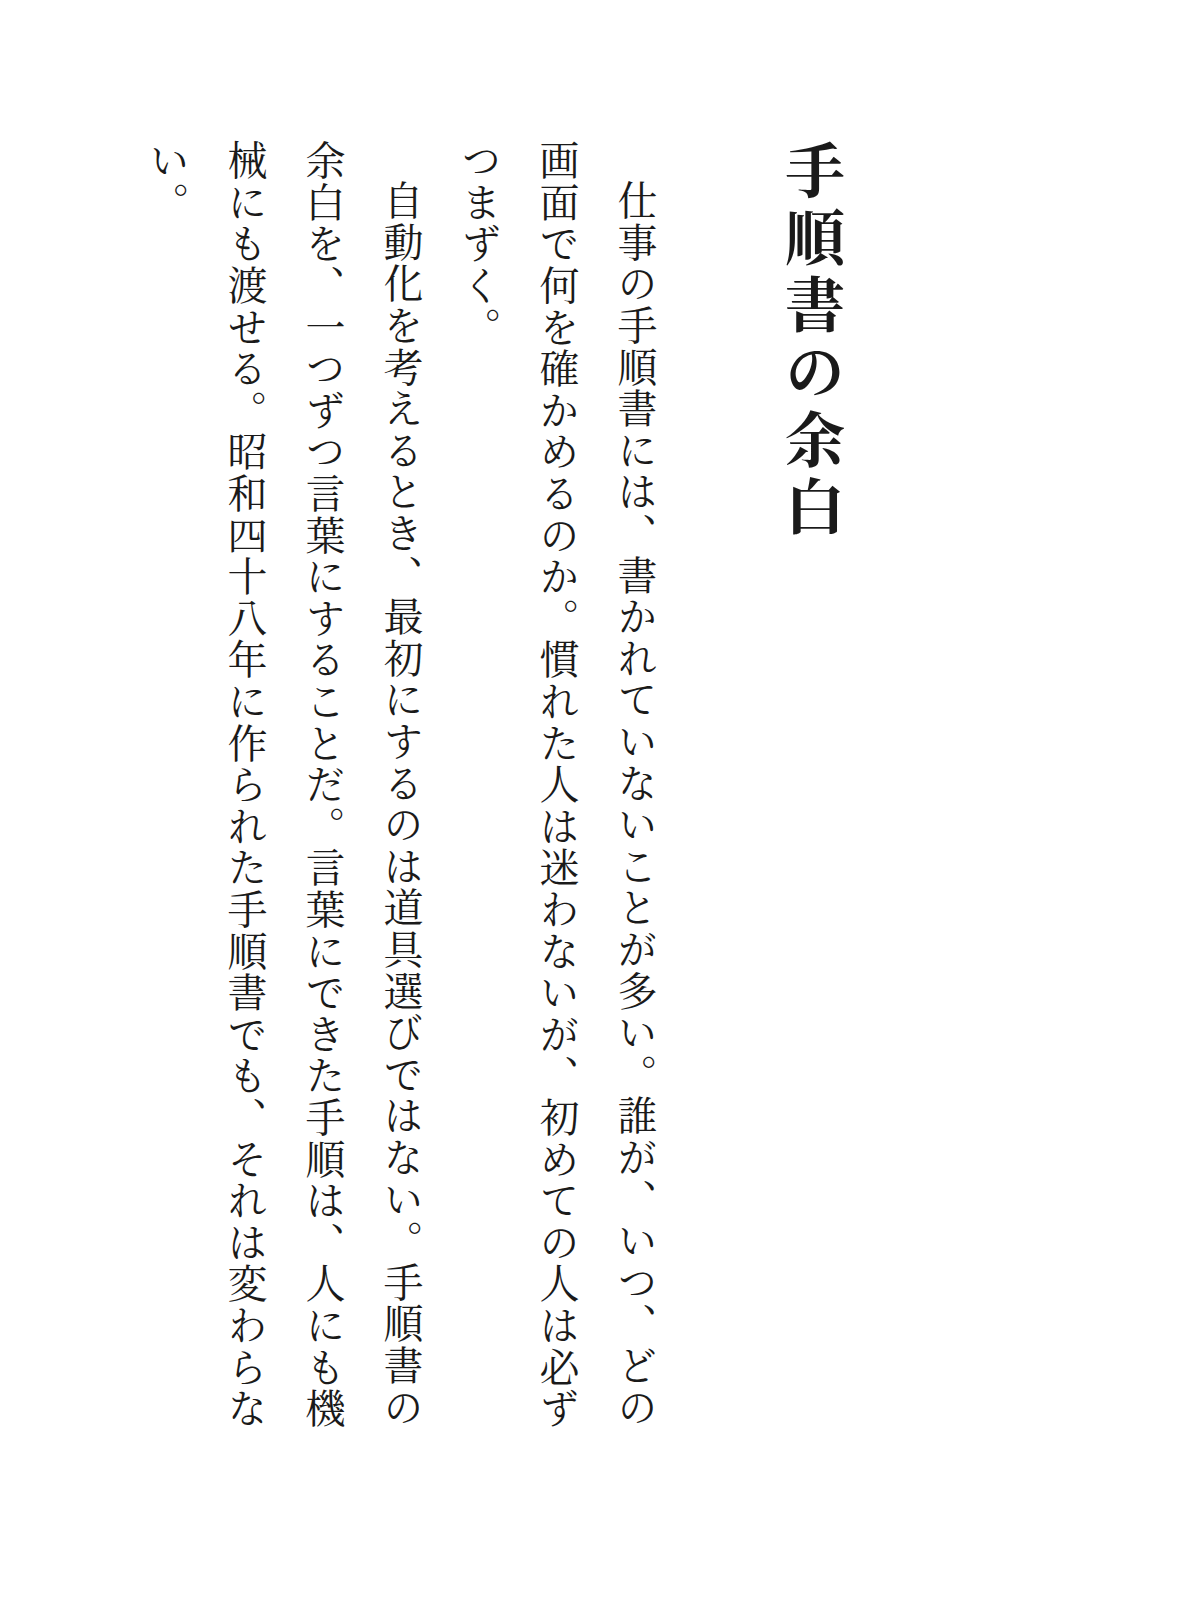 縦
書きの読み物明朝体・縦書き・2段落
- NDLOCR-Lite 0.6%
(本家と 全文 一致) - PaddleOCR 9.6%
- Tesseract 1.2%
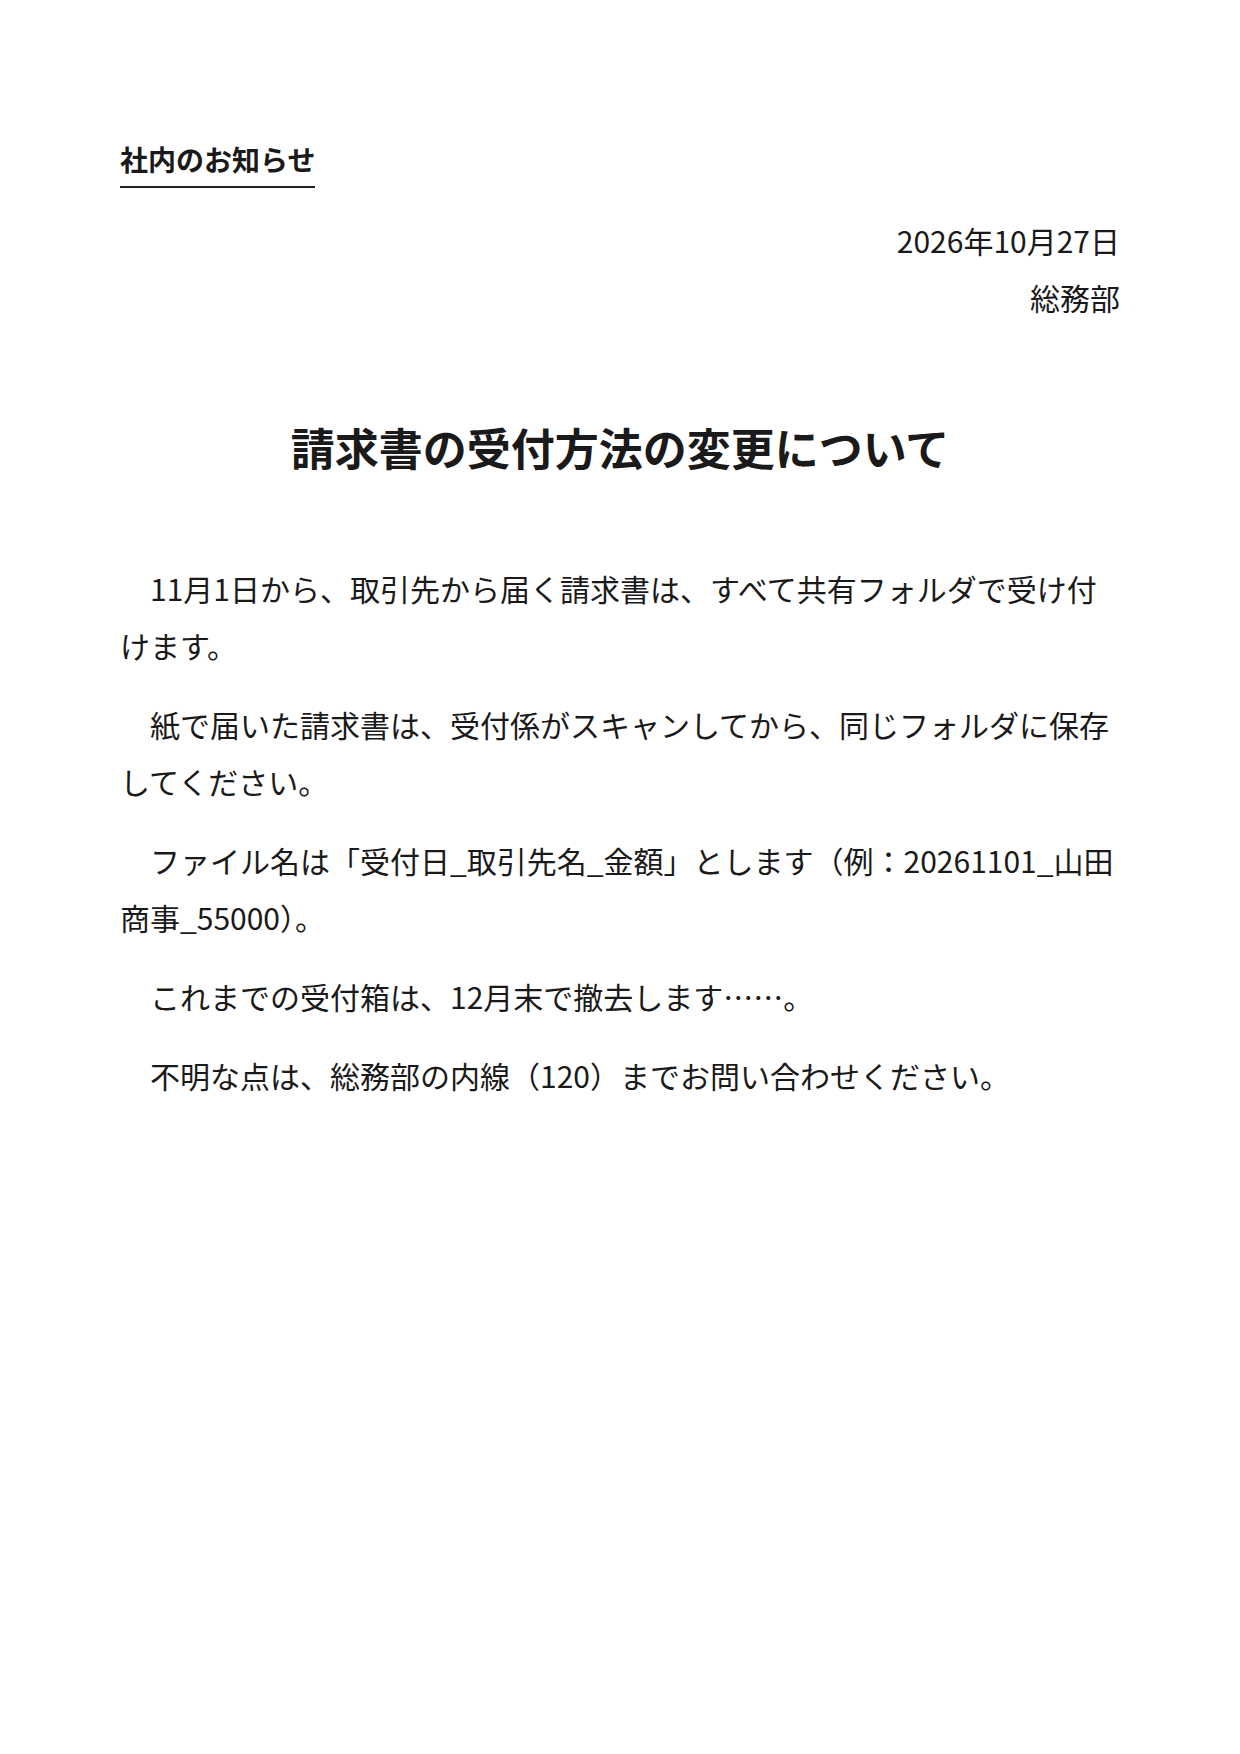 横
書きの社内文書ゴシック体・見出しと本文
- NDLOCR-Lite 1.9%
(本家と 全文 一致) - PaddleOCR 0.0%
- Tesseract 0.5%
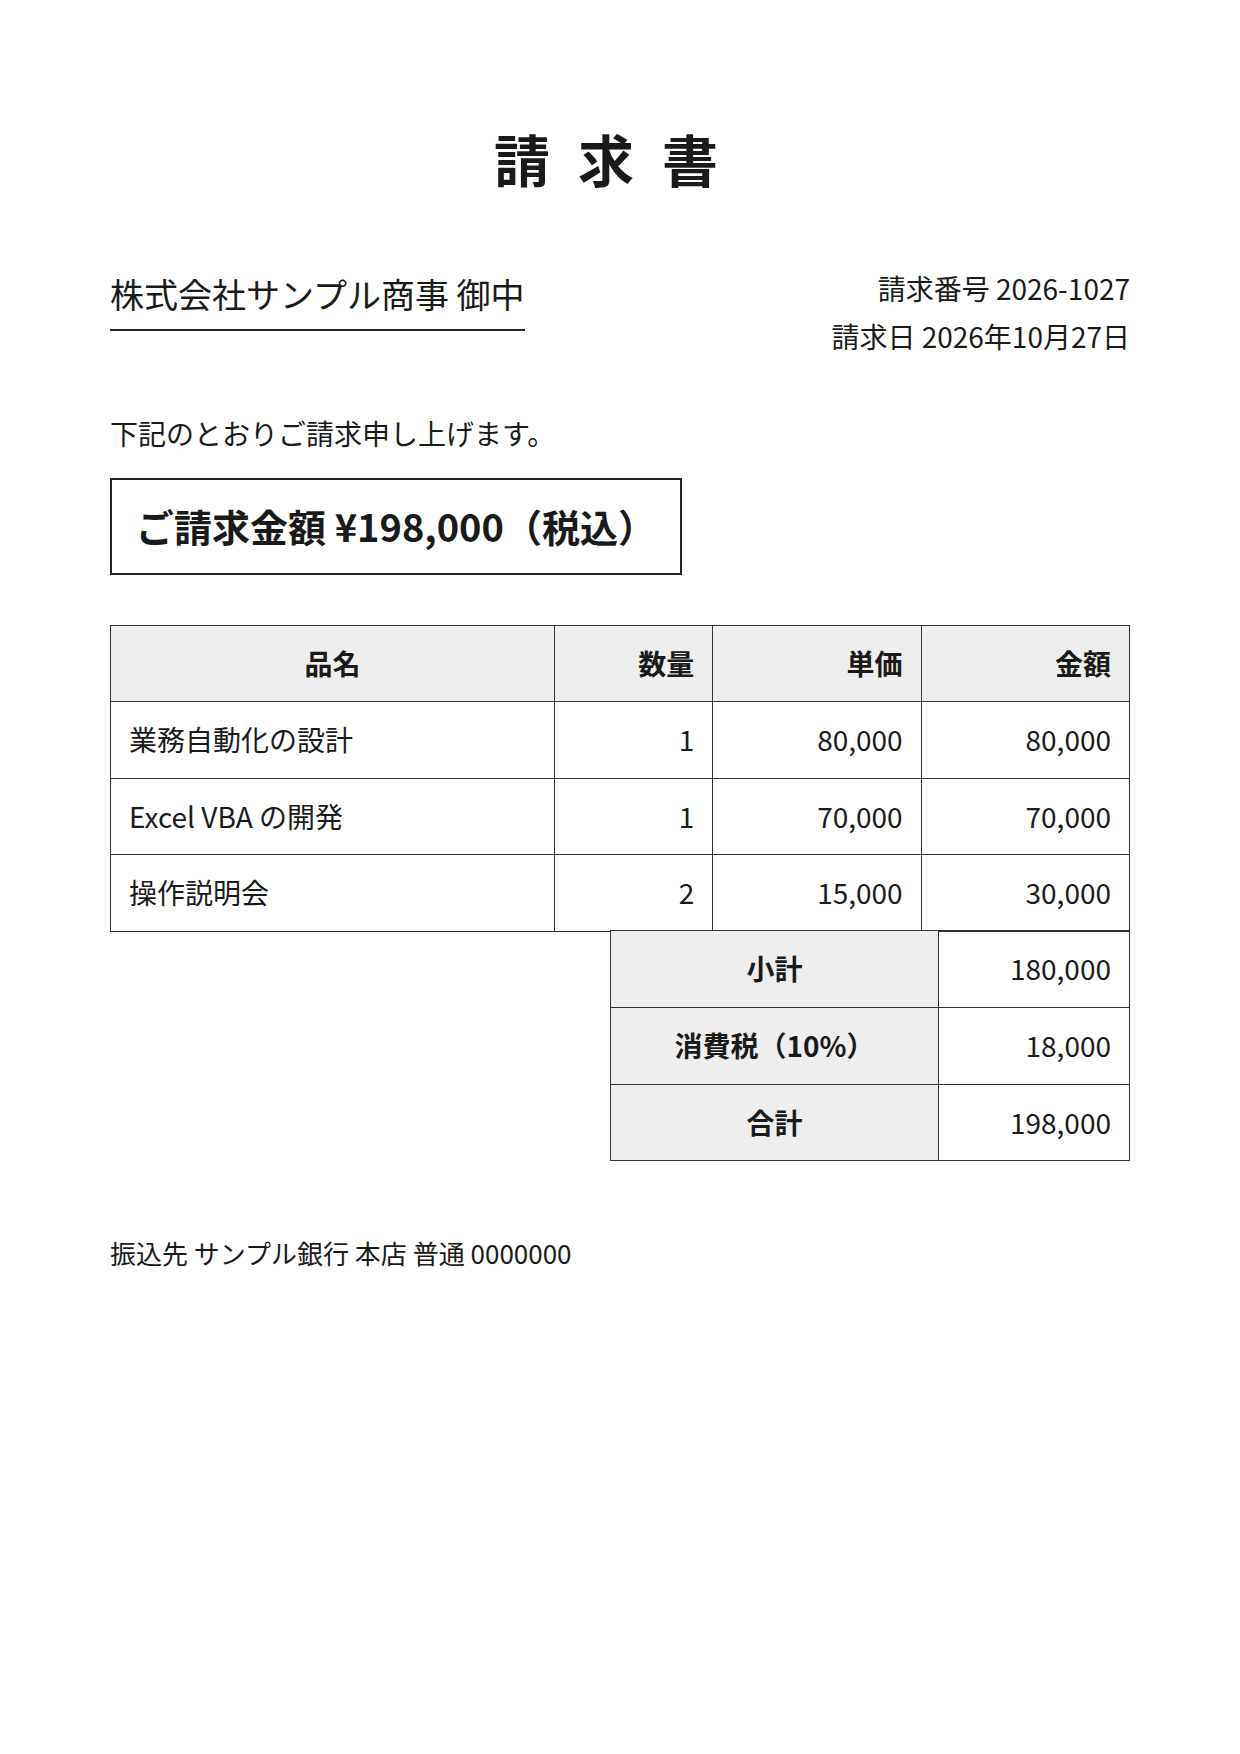 請求書
(表)罫線の表・数字・金額
- NDLOCR-Lite 66.2%
(本家と 全文 一致) - PaddleOCR 28.3%
- Tesseract 2.5%
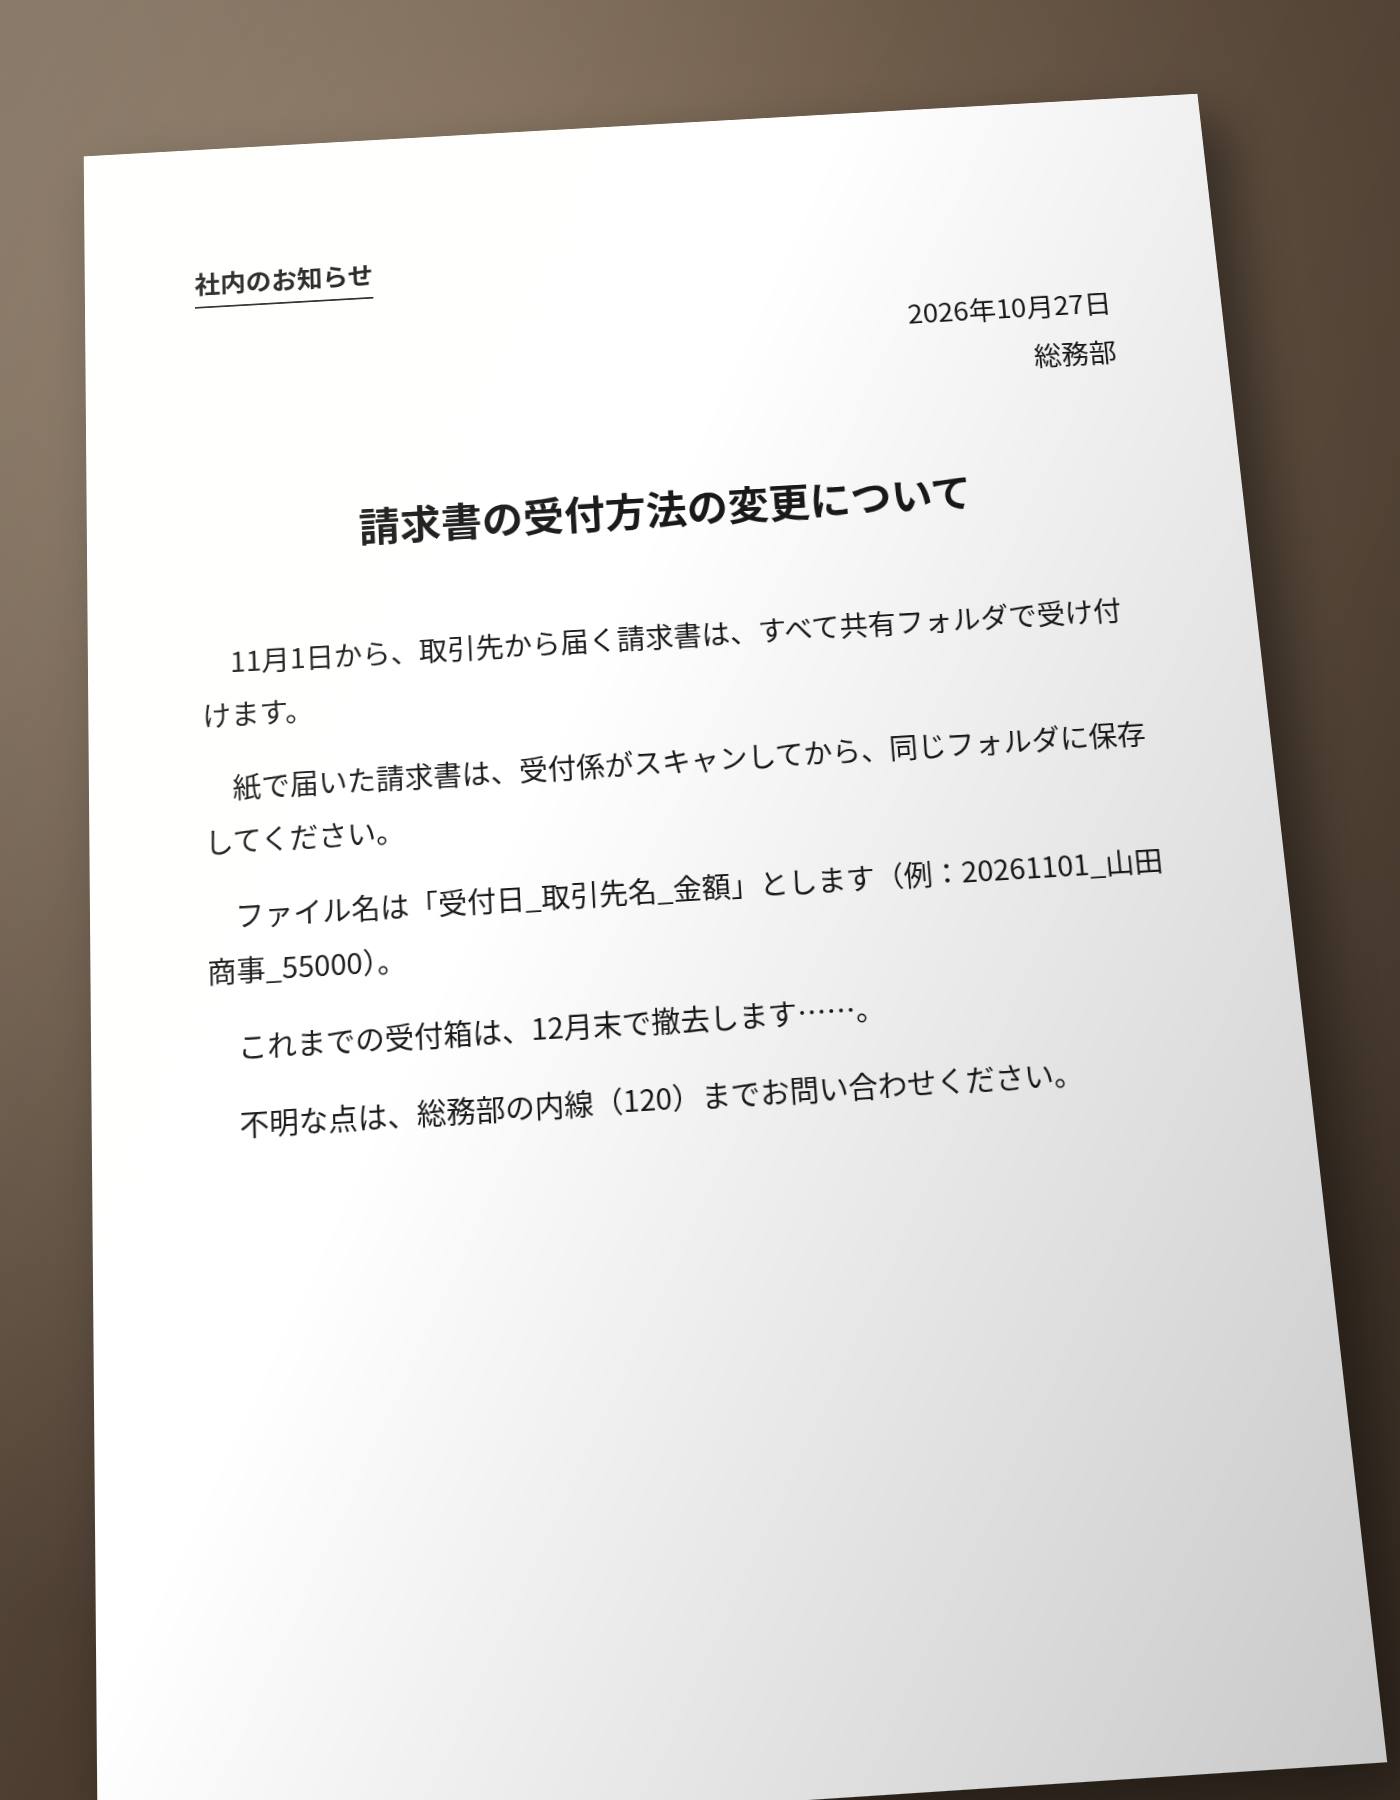 スマホで
撮った書類傾き・影・ぼけ・JPEG
- NDLOCR-Lite 5.6%
(本家と 全文 一致) - PaddleOCR 4.6%
- Tesseract 24.1%
- 見本は
コンピューターで 描いた 画像です。 本番の 判断は、 手元の 書類で。 - 表や
縦書きの 段組みは、 読む 順番の 違いも 誤りに 数えます。 一致率も 見てください。
数値の表(一致率つき)と測り方
| 見本 | NDLOCR-Lite | PaddleOCR | Tesseract |
|---|---|---|---|
| 縦 | 誤り 0.6% 一致 99.4% | 誤り 9.6% 一致 95.0% | 誤り 1.2% 一致 99.4% |
| 横 | 誤り 1.9% 一致 98.6% | 誤り 0.0% 一致 100.0% | 誤り 0.5% 一致 99.8% |
| 請求書 | 誤り 66.2% 一致 98.7% | 誤り 28.3% 一致 99.0% | 誤り 2.5% 一致 97.5% |
| スマホで | 誤り 5.6% 一致 96.2% | 誤り 4.6% 一致 97.2% | 誤り 24.1% 一致 96.2% |
2026年10月29日、
確から
- NDLOCR-Lite国立国会図書館・CC BY 4.0(レイアウトの
モデルは DINOv3 License も 適用) 本家の コード (2026-10-08 版)を そのまま 得意活字の
書籍・雑誌、 縦書き、 段組み、 旧字体 苦手帳票、
公開元手書き (公式も 帳票は 対象外と 明言) - PaddleOCR
(PP-OCRv5 mobile) PaddlePaddle PP-OCRv5 mobile(Baidu) ・Apache-2.0 (公式の Hugging Face の ONNX) 得意横
書きの 帳票・看板・写真の 中の 文字 苦手縦
公開元書きの 長文 (行の 向きの 扱い) - TesseractTesseract OCR
(Google 発の Tesseract 5.3.4(Ubuntu のオープンソース) ・Apache-2.0 公式パッケージ) 得
意 きれいに印刷された 横書き。 長い 実績 苦手傾き・影・ぼけの
公開元ある 写真 (見本の 実測で 差が 出た)
02仕組み
重い計算は、 サーバー で。
モデルは
弊社の
1つずつ
- NDLOCR-Lite
- PaddleOCR
- Tesseract
- メモリの
中だけで 読む - 読み終えたら
捨てる
- Hugging FacePaddleOCR の
モデルを 事前に 配置。 読み取り中の 通信なし - Baidu の
取得先 PaddleOCR の 既定。 使わない - 外部の
サービス 画像を送らない
詳しく:本家との全文一致と、モデルの出所
NDLOCR-Lite は、本家そのもの
国立国会図書館が
| 見本 | 文字誤り | 本家の |
|---|---|---|
| 縦 | 0.6% | 全文 |
| 横 | 1.9% | 全文 |
| 請求書 | 66.2% | 全文 |
| スマホで | 5.6% | 全文 |
外部への通信は無し
PaddleOCR の
03ライセンスと
使っているもの。
- NDLOCR-Lite
(国立国会図書館) CC BY 4.0。 レイアウト認識の モデルには DINOv3 License (Meta)も 適用されます。 ライセンス ・DINOv3 License - PaddleOCR
(PP-OCRv5 mobile) Apache-2.0。 モデルは PaddlePaddle 公式の Hugging Face の ONNX。 前処理・後 処理は PaddleOCR と 同じ 手順を 弊社で 書いています。 ライセンス - Tesseract 5.3.4(Ubuntu の
公式パッケージ・日本語の 横書きと 縦書きの データ) Apache-2.0。 ライセンス - ONNX Runtime
(Microsoft・サーバーでの 推論) MIT。 ライセンス